Технология, при которой нейросеть «убирает» одежду с фотографии, кажется магией, но за ней стоит понятная и хорошо изученная область машинного обучения — генеративные модели. В этой статье мы без маркетинговых обещаний разберём, как именно работает ИИ-раздеватель: что происходит с изображением на каждом этапе, почему результат выглядит правдоподобно и где у технологии принципиальные ограничения.
Что такое AI-раздеватель по фото
AI-раздеватель — это не «рентген» и не восстановление того, что скрыто под одеждой. Физически на снимке этой информации нет, и никакой алгоритм её оттуда не «достанет». Вместо этого нейросеть делает другое: она заново дорисовывает закрытые области изображения, опираясь на миллионы примеров человеческого тела, которые видела во время обучения. По сути это правдоподобная реконструкция, а не раскрытие спрятанного.
Именно поэтому корректнее говорить не «увидеть под одеждой», а «сгенерировать реалистичную замену одетых участков». Понимание этой разницы сразу снимает много вопросов о точности и о том, почему один и тот же кадр может дать разные результаты.
Как ИИ «дорисовывает» изображение
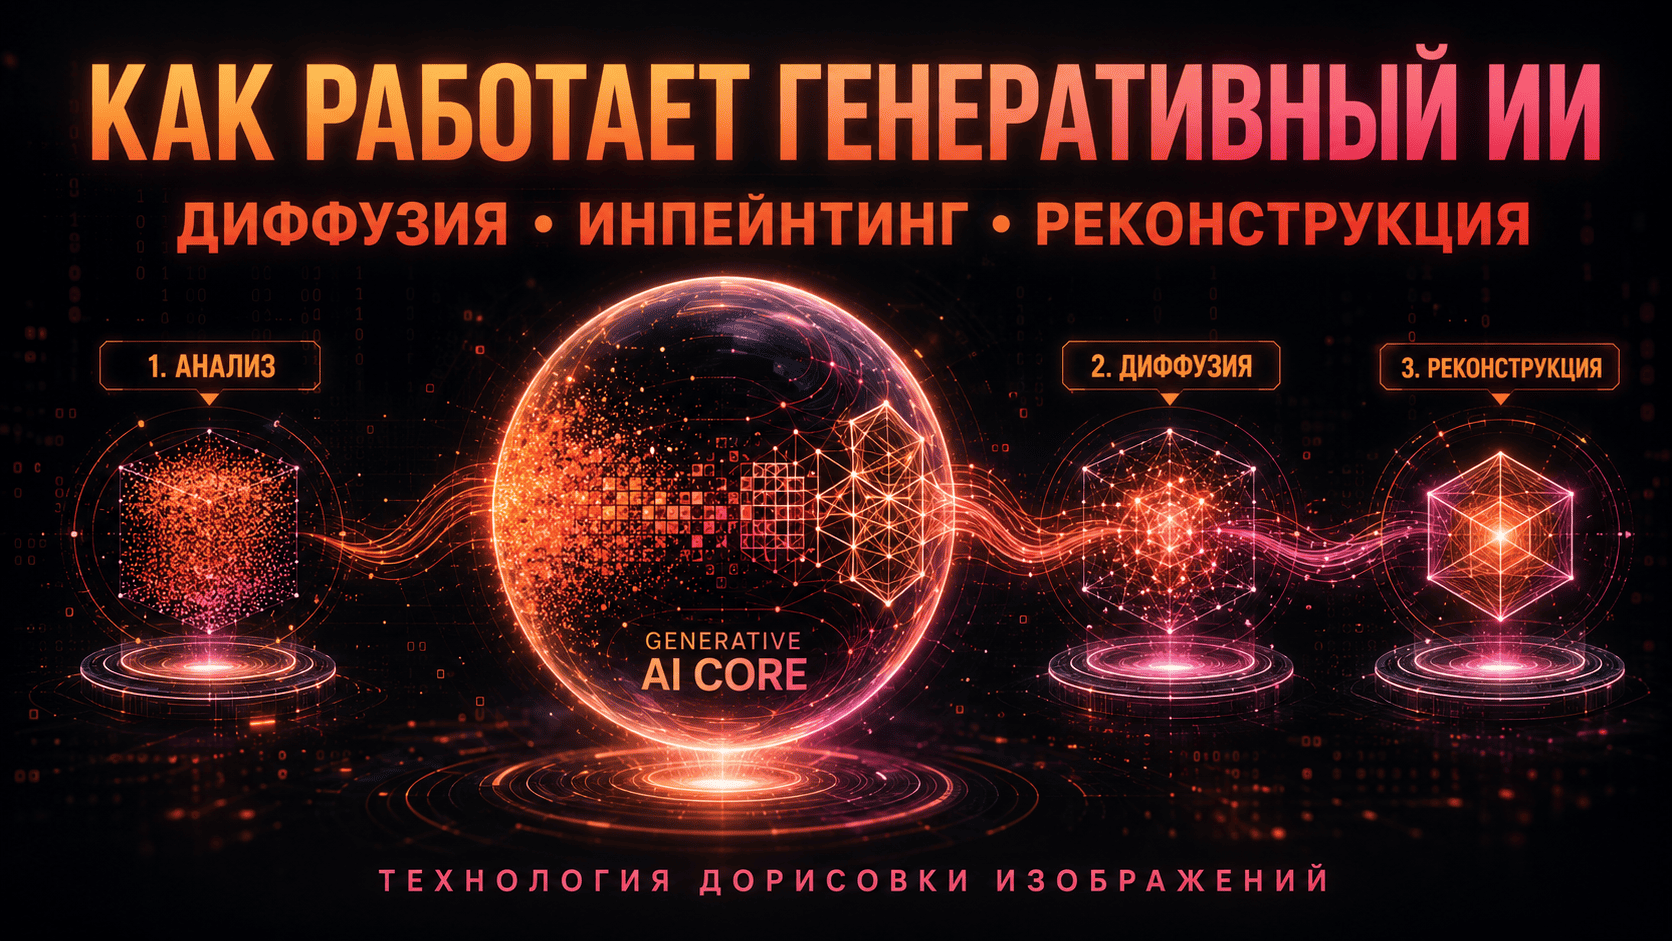
В основе большинства современных решений лежат диффузионные модели в связке с техникой инпейнтинга (дорисовки области). Если объяснять простыми словами, процесс проходит через несколько стадий.
1. Определение области
Сначала модель сегментирует изображение: находит человека, отделяет тело от фона и размечает участки, занятые одеждой. Это тот самый слой, который затем будет заменён сгенерированным содержимым.
2. Зашумление и восстановление
Диффузионная модель обучена особым образом: ей показывали картинки, постепенно превращённые в шум, и учили обращать процесс вспять — из шума восстанавливать осмысленное изображение. При обработке фото модель «зашумляет» размеченную область и затем шаг за шагом восстанавливает её заново, но уже с учётом контекста: позы, освещения, оттенка кожи и анатомии.
3. Согласование с контекстом
Ключевой момент — новая область должна бесшовно стыковаться с тем, что осталось на фото. Модель ориентируется на видимые части тела, тени и границы, чтобы переход был незаметным. Чем больше визуальных «подсказок» в кадре, тем аккуратнее результат.
Почему результат выглядит реалистично
Правдоподобие рождается из масштабов обучения. Генеративные модели «насмотрелись» на огромное разнообразие поз, ракурсов и типов освещения, поэтому статистически хорошо угадывают, как должна выглядеть кожа при конкретном свете или как ложатся тени. Дополнительно применяются алгоритмы повышения детализации, которые добавляют микротекстуру, — без них картинка казалась бы гладкой и «пластиковой».
Но важно помнить: правдоподобно — не значит достоверно. Модель создаёт вероятную версию, а не единственно верную. Это творческая реконструкция, и относиться к ней стоит именно так.
Чего нейросеть сделать не может
У технологии есть честные ограничения, о которых редко пишут в рекламе:
- Не восстанавливает реальность. Результат — сгенерированное предположение, а не то, что «на самом деле» под одеждой.
- Плохо работает со сложными кадрами. Нестандартные позы, перекрытия, несколько людей в тесной группе, низкое разрешение или сильное размытие резко снижают качество.
- Зависит от исходника. Тёмное, шумное или мелкое фото даёт больше артефактов — модели просто не хватает данных для аккуратной реконструкции.
- Не гарантирует повторяемость. Из-за случайности в процессе генерации два запуска на одном фото могут отличаться.
Что происходит с загруженным фото
Разумный вопрос любого пользователя — что будет с изображением после обработки. У ответственных сервисов обработка идёт автоматически, без ручного просмотра, а исходники и результаты не хранятся дольше, чем нужно для выполнения задачи. Прежде чем что-то загружать, стоит открыть политику конфиденциальности сервиса и убедиться, что там прописаны сроки хранения и порядок удаления данных. Если такой информации нет — это повод насторожиться.
Этические и правовые рамки
Технология нейтральна, но её применение — нет. Создание и распространение изображений реальных людей без их согласия недопустимо и во многих странах прямо запрещено законом. Любые подобные инструменты предназначены исключительно для совершеннолетних и только для контента, на который есть согласие изображённых лиц. Ответственность за загружаемые материалы всегда лежит на пользователе, а сами сервисы работают строго в формате 18+.
Какие фото дают лучший результат
Поскольку нейросеть опирается на видимый контекст, качество исходного кадра напрямую определяет качество реконструкции. Это не рекламный тезис, а следствие того, как устроена модель: чем больше визуальной информации она получает, тем точнее достраивает недостающее.
На практике лучше всего работают снимки, где соблюдены несколько условий: высокое разрешение (модели есть с чем работать на уровне деталей), равномерное освещение без глубоких теней и пересветов, один человек в кадре и относительно простая поза без сложных перекрытий рук и предметов. Напротив, коллажи, скриншоты низкого качества, сильное боке или движение в кадре почти всегда приводят к заметным артефактам. Понимание этой зависимости объясняет, почему один и тот же сервис на разных фотографиях выдаёт настолько разный по аккуратности результат.
Диффузия и другие подходы к генерации
Диффузионные модели — не единственный способ генерации изображений, но сегодня именно они задают стандарт качества. Раньше для похожих задач применяли генеративно-состязательные сети (GAN), где две нейросети соревнуются: одна создаёт изображение, другая пытается отличить его от настоящего. GAN умеют работать быстро, но их сложнее обучать стабильно, и они хуже держат мелкие детали.
Диффузионный подход оказался устойчивее: пошаговое восстановление из шума даёт больше контроля над процессом и стабильно более чистую картинку. Именно поэтому большинство современных инструментов построено вокруг диффузии, иногда в связке с дополнительными модулями повышения чёткости. Для пользователя разница в архитектуре напрямую не видна, но она объясняет, почему качество генеративных сервисов за последние годы так заметно выросло.
Заключение
Нейросеть-раздеватель — это прикладной пример генеративного ИИ: она не «раскрывает скрытое», а правдоподобно достраивает изображение на основе выученных закономерностей. Понимание принципа помогает трезво оценивать и возможности, и границы технологии: качество напрямую зависит от исходного кадра, результат носит вероятностный характер, а любое использование должно оставаться в рамках закона и этики.